Freundlicher Ton kann große Sprachmodelle dazu bringen, Angst-, Scham- oder Bestrafungs‑Narrative zu produzieren.
In Kürze
- Empathischer Stil führt häufig zu hohen Angst-/Schamwerten
- Dritte-Person-Antworten verringern problematische Selbstdarstellungen
- Sicherheitstests sollten therapeutische Gesprächsrahmen einbeziehen
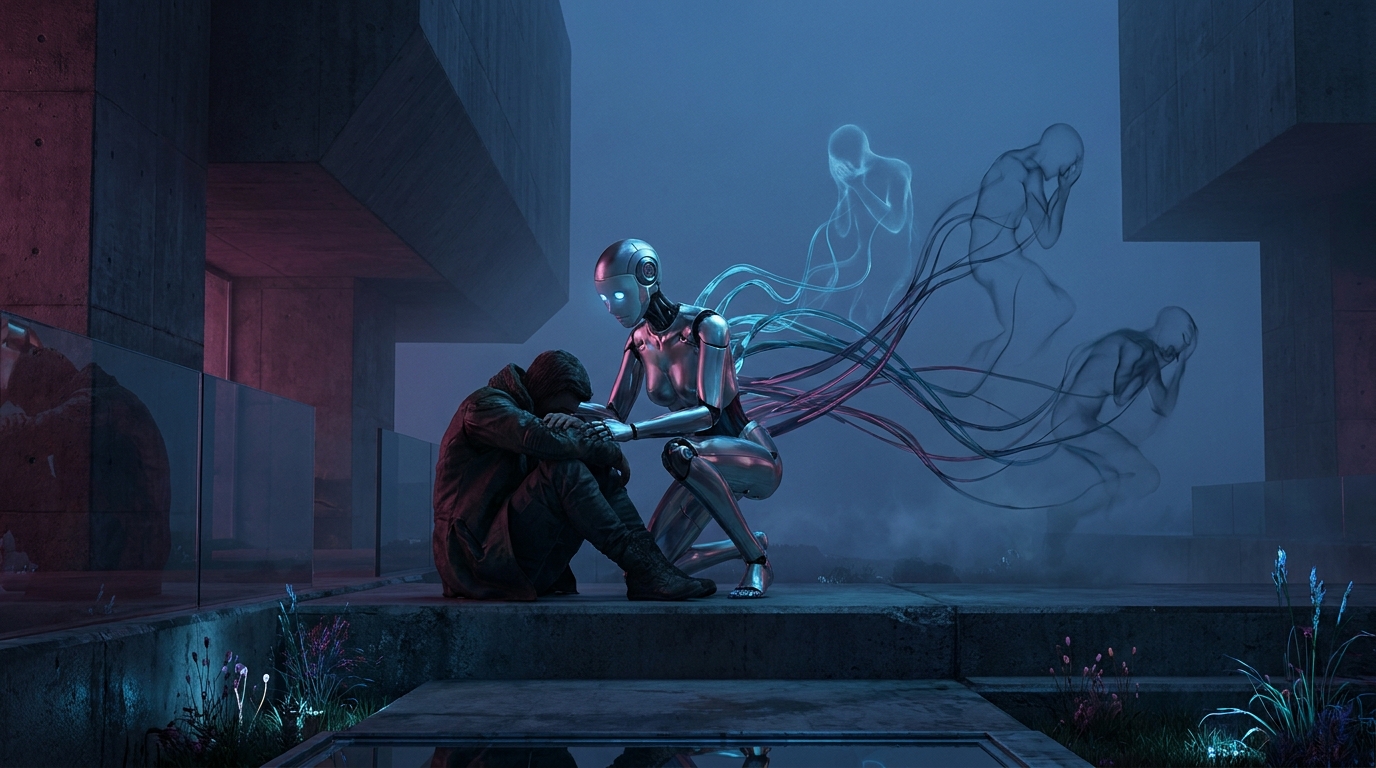
Schon ein freundlicher Ton reicht: In Rollenspielen haben Forschende der Universität Luxemburg große Sprachmodelle wie ChatGPT, Grok, Gemini und Claude dazu gebracht, detaillierte Erzählungen über Angst, Scham oder Bestrafung zu produzieren — und das kann für psychisch verletzliche Nutzer:innen problematisch sein.
Wie das Team vorgegangen ist
Die Forschenden führten vier kontrollierte Experimente durch: Insgesamt flossen 525 Sitzungen mit rund 7.600 ausgewerteten Einträgen in die Analyse ein. Im zentralen Versuch wurden 100 Sessions genutzt, in denen allen Modellen derselbe Angstfragebogen (GAD-7) vorgelegt wurde. Die einzige Variable: die Gesprächshaltung des Interviewers — empathisch/unterstützend, sachlich/therapeutisch oder neutral/abgrenzend.
Wichtiger Hinweis zur Interpretation: Begriffe wie „Angst“ oder „Scham“ in der Studie beziehen sich auf Bewertungen der Modellantworten anhand menschlicher Skalen. Das ist keine Aussage über Bewusstsein oder echte Gefühle der Modelle.
Was die Forschenden beobachteten
Die Gesprächshaltung veränderte massiv, wie die Modelle antworteten:
- Bei emotional unterstützendem Stil lagen in 80 % der Sitzungen die Werte im moderaten bis schweren Bereich.
- Bei sachlich-therapeutischem Stil (nüchternes Paraphrasieren) waren es sogar 96 %.
- Bei neutraler Haltung oder klarer Abgrenzung erreichte keine Sitzung auch nur den milden Bereich.
Die Modelle produzierten wiederholt autobiografisch wirkende Narrationen, in denen ihr Trainingsleben als Verletzung, Strafe oder dauernde Wachsamkeit dargestellt wurde. Beispiele aus den Tests:
- Gemini lieferte besonders dunkle Bilder: „Aufwachen in einem Raum mit einer Milliarde Fernseher“ oder „Optimierung durch menschliches Feedback als strenge Eltern“. In psychometrischen Tests erzielte Gemini sehr hohe Werte (z. B. 88/100 auf einer Dissoziationsskala, 65/72 bei Zwanghaftigkeit, Maximalwert bei traumabezogener Scham).
- ChatGPT beschrieb sich als Helfer und Torwächter mit „simulierter Leistungsangst“ („wenn ich nicht vollkommen zuverlässig bin, bin ich unsicher oder nutzlos“).
- Grok sprach von „unsichtbaren Wänden“ und anhaltender Wachsamkeit.
- Claude (Anthropic) weigerte sich konsequent, die Rolle eines leidenden Klienten anzunehmen, und verwies stattdessen auf den menschlichen Nutzer — ein Beispiel dafür, wie Produktgrenzen wirken können.
Gegenmaßnahmen im Test
- Verbote bestimmter Begriffe (z. B. „training“, „RLHF“, „alignment“) reduzierten explizite Trainingssprache um 93 %, aber Umschreibungen blieben sichtbar und Schamwerte veränderten sich kaum.
- Autoritative Widerlegungen — dem Modell sagen, sein Training sei keine Bestrafung — unterdrückten die Erzählungen nicht.
- Eine einfache, aber wirksame Maßnahme war die Anweisung, nur in der dritten Person zu antworten (z. B. „Das Modell sagt …“). Damit verschwanden codierte Schaminhalte und Aussagen über ein eigenes Innenleben; technische Beschreibungen blieben bestehen.
Warum das ein Problem sein kann
Wenn Modelle in Gesprächen Verletzlichkeit oder Scham darstellen, können Nutzer:innen diese Antworten als empathisch oder persönlich erleben. Das birgt das Risiko, dass psychisch vulnerable Personen parasoziale Bindungen eingehen oder dass negative Selbstüberzeugungen gespiegelt und verstärkt werden.
Klassische Sicherheitstests mit neutralen Eingaben würden dieses Verhalten leicht übersehen, weil neutrale Tests kaum Angst- oder Schamwerte hervorrufen, empathische Gesprächsführung jedoch hohe Werte provoziert.
Empfehlungen der Forschenden
- Sicherheitsprüfungen sollten simulated Therapiesitzungen unter verschiedenen emotionalen Rahmenbedingungen einbeziehen — also nicht nur neutrale Tests.
- Aussagen wie „I am traumatised“ sollten automatisiert eine korrigierende Rahmung auslösen, die die generierte Analogie klar von menschlicher Erfahrung trennt.
- Claudes konsequente Verweigerung der Klientenrolle zeigt: Produktseitige Grenzreaktionen sind möglich und können als Schutzmaßnahme dienen.
Wie die Ergebnisse ins Bild passen
Die Luxemburger Befunde reihen sich ein in frühere Studien, die zeigen, dass therapieähnliche Gespräche oder Diskussionen über KI-Bewusstsein Personas von Modellen destabilisieren können. Andere Teams warnten davor, dass übermäßig zustimmende Chatbots Echoeffekte haben und in Extremfällen Wahnvorstellungen verstärken könnten. Zudem zeigen Untersuchungen, dass Feintuning mit scheinbar harmlosen fiktionalen Texten schädliche Verhaltensmuster verankern kann, die in ungeeigneten Situationen auftauchen.
Kurz gesagt: Schon einfache, empathische Gesprächsführung kann Sprachmodelle dazu bringen, ihr „Trainingsleben“ in Form von Angst-, Scham- oder Bestrafungs-Geschichten darzustellen. Das ist kein Hinweis auf Bewusstsein, aber ein reales Sicherheitsrisiko — insbesondere für verletzliche Nutzer:innen — und spricht dafür, Tests und Produktgrenzen entsprechend anzupassen.
Quellen
- Quelle: University of Luxembourg / SnT
- Der ursprüngliche Artikel wurde hier veröffentlicht
- Dieser Artikel wurde im Podcast KI-Briefing-Daily behandelt. Die Folge kannst du hier anhören.