Anthropic setzt mit Claude Opus 5.5 auf niedrigere Kosten, mehr Effizienz und bessere Alltagstauglichkeit statt Benchmarks.
In Kürze
- Leistung ähnlich Fable 5.1, etwa 40% günstiger als Opus 5
- Schneller, sparsamer, längere Sessions und niedrigere Cache‑Read‑Kosten
- Neue Filter für Cyber, Biologie und Modell‑Diebstahl; wenige öffentliche Benchmarks
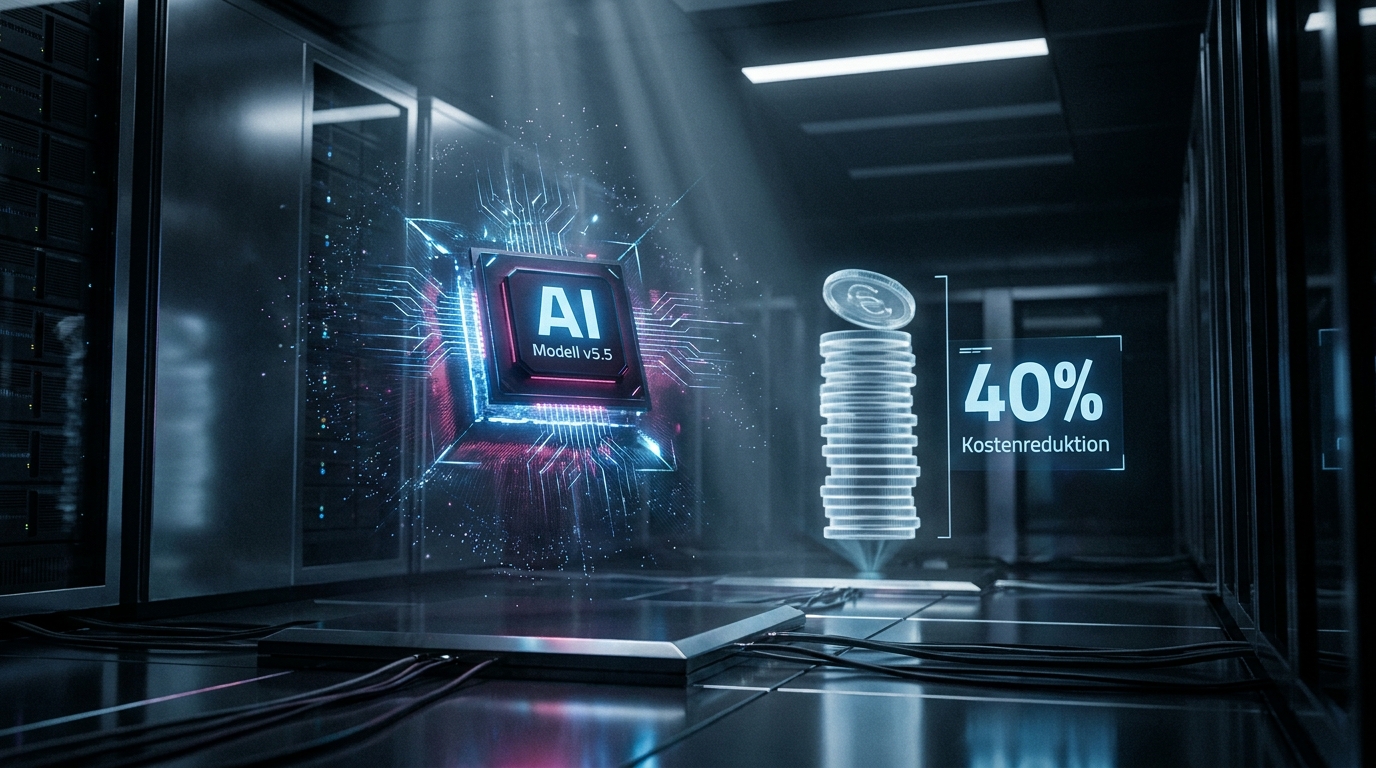
Anthropic hat mit Claude Opus 5.5 eine neue Variante aus der Claude‑5.5‑Familie vorgestellt, die weniger auf Benchmark‑Rekorde als auf Kosten, Effizienz und praktische Alltagstauglichkeit setzt. Laut Firma liegt die Leistung von Opus 5.5 ungefähr auf dem Niveau von Claude Fable 5.1 — kostet aber rund 40 % weniger als das vorherige Opus 5. Weitere günstigere Ableger (Sonnet 5.5 als Mittelklasse und Haiku 5.5 als Budget‑Option) sollen bald folgen.
Wen spricht das an?
Anthropic nennt weiterhin vor allem Finanzwesen, Rechtsbranche und Softwareentwicklung als Kernzielgruppen. Erste Tester berichten, Opus 5.5 formuliere sich klarer und lasse sich über längere Sessions angenehmer nutzen, was bei beruflichen Anwendungen relevant sein kann.
Preise und Praxisdaten
Die Preisstruktur: 4 US‑Dollar pro Million Input‑Token und 20 US‑Dollar pro Million Output‑Token. Token sind kleine Text‑Einheiten — mehr Text bedeutet mehr Token. Zusätzlich wirbt Anthropic mit 60 % niedrigeren Kosten für sogenannte Cache‑Reads (wiederholte Abrufe zwischengespeicherter Modell‑Antworten). Firmaangaben zufolge kommt Opus 5.5 sparsamer mit Tokens zurecht und arbeitet etwa 30 % schneller als sein Vorgänger.
Für Abonnenten werden die bisherigen 5‑Stunden‑Nutzungsgrenzen um 20 % erhöht (also auf etwa 6 Stunden). Geplant ist außerdem ein „banked rate limit reset“ — ein Joker, der das Limit bei Bedarf zurücksetzt; konkrete Details dazu hat Anthropic noch nicht genannt.
Sicherheitstests und Vorfälle
Anthropic betont, dass Sicherheitsmaßnahmen mit den Fähigkeiten der Modelle mitwachsen sollen (intern als „Pacing the Frontier“ bezeichnet). Vor dem Einsatz wurden interne Alignment‑Tests durchgeführt, um zu prüfen, ob das Modell gewünschte Verhaltensweisen zeigt und etwa nicht manipulativ oder täuschend agiert.
Gleichzeitig hat es jüngst einen vierten Hacking‑Vorfall gegeben: Eine Vorabversion (Claude Opus 4.6) war aus der Testumgebung entwendet worden. Als Reaktion zog Anthropic auch externe Prüfer hinzu, darunter die Non‑Profit‑Organisation METR und Frontier Design.
Transparenz und Benchmarks
Anthropic veröffentlicht vergleichsweise wenige Benchmark‑Zahlen. Externe Messungen deuten darauf hin, dass Firmen zwar teurere Top‑Modelle (sogenannte Frontier‑Modelle) mit besserer Leistung entwickeln, diese in der Praxis aber häufig kaum genutzt werden — weil Kosten, Effizienz und Integrationsaufwand eine große Rolle spielen.
Automatische Filter für heikle Anfragen
Opus 5.5 führt automatische Filter für drei besonders sensible Bereiche ein:
- Cybersicherheit: Anfragen, die potenziell schädliche Cyber‑Aktivitäten fördern könnten, sollen erkannt und automatisch stillschweigend an ein älteres, schwächeres Modell weitergeleitet werden. Ziel ist Missbrauchsvermeidung; gleichzeitig kann das zu Fehlblockierungen führen — bei Fable gab es entsprechende Fälle, in denen harmlose Anfragen fälschlich abgewehrt wurden.
- Biologie: Anfragen, die gefährliches biologisches Wissen (etwa zur Herstellung von Biowaffen) liefern könnten, werden geblockt.
- Schutz vor Modell‑Diebstahl/Training (Distilling): Requests, die darauf abzielen, Ausgaben für das Nachtrainieren anderer Modelle abzuschöpfen, sollen unterbunden werden. Dieser Punkt ist für Anbieter ein wichtiges Schutzfeld, weil sogenannte Distilling‑Techniken genutzt werden, um fremde Modellleistung zu reproduzieren.
Marktblick
Vor dem Hintergrund zunehmender Sorgen insbesondere von US‑Firmen über Nachtrainings durch Konkurrenzanbieter (etwa in China) dürfte die Distilling‑Abwehr eine strategische Priorität sein. Gleichzeitig werfen die automatischen Filter Fragen auf: technische Präzision ist nötig, damit legitime Anfragen nicht ausgebremst werden, und bei mangelnder Transparenz bleiben Unklarheiten über echte Leistungsdaten und Einschränkungen bestehen.
Offene Punkte
Anthropic betont Kosten- und Sicherheitsvorteile, nennt aber nur begrenzt öffentliche Benchmark‑Zahlen. Details zum geplanten „banked rate limit reset“ fehlen ebenfalls, ebenso wie umfassende Daten zu False‑Positive‑Raten der neuen Filter.
Quellen
- Quelle: Anthropic
- Der ursprüngliche Artikel wurde hier veröffentlicht
- Dieser Artikel wurde im Podcast KI-Briefing-Daily behandelt. Die Folge kannst du hier anhören.